ML study guide past exams
من الدورات نفسها · محلول ضمن حدود المحاضرات

أسئلة تاريخية، بإجابات قابلة للكتابة في الامتحان.

نص السؤال أولاً، ثم الفكرة الحاسمة، ثم الحساب أو الرسم المطلوب. تظهر المصطلحات الأساسية بالعربية ومعها الاسم الإنجليزي القياسي، وكل بطاقة تعيدك إلى صورة الصفحة الأصلية وإلى الدرس الموافق في الدليل.

المصدر ملف دورات_سنبل.pdf فقط للأسئلة.
الحل الدليل ومحاضرات الأسابيع 1–10 فقط.
القاعدة لا نخمن رقماً أو فرضية أخفاها السؤال.
المحور 1

التقييم والتعميم

أسئلة تتكرر بصيغ مختلفة: ما الذي نتعلمه؟ كيف نقيسه؟ ومتى تكون النتيجة المبهرة مضللة؟

افتح درس التقييم
الدورة Aصفحة 1 · س1 · 20 علامة

Parameters، التقسيم، أخطاء التصنيف، وانتقاء السمات

خلاصة نص السؤال:

  1. ما الفرق بين parameters وhyperparameters؟ أعط مثالاً في ID3.
  2. هل تقسيم 50% training / 50% test مكافئ لـ2-fold cross-validation؟
  3. عرّف FP وFN، ومتى يكون تقليل كل منهما أهم؟
  4. قارن انتقاء السمات المشرف وغير المشرف: أيهما يعطي سمات أفضل؟
الحل الواضح المختصر

1) وسيط النموذج (Parameter) أم المعامل الفائق (Hyperparameter)؟

وسيط النموذج (Parameter) يتعلمه النموذج من بيانات التدريب؛ في ID3 بنية الشجرة نفسها - السمة في كل عقدة والفروع وتنبؤات الأوراق - ناتج متعلم. المعامل الفائق (Hyperparameter) نختاره قبل التدريب ونضبطه على بيانات التحقق؛ مثل max_depth أو الحد الأدنى للمعلومات أو قواعد التقليم.

Validation→اختيار العمق→Training→تعلم الشجرة

2) الفصل البسيط (Holdout) ليس تحققاً متقاطعاً (Cross-Validation)

في كل تدريب منفرد تُستخدم نصف البيانات، لكن holdout يبني نموذجاً واحداً ويتعلق بنتيجة تقسيم واحد. أما 2-fold CV فيبني نموذجين: مرة ندرب على A ونحقق على B، ثم نعكسهما، وكل مثال يدرب مرة ويحقق مرة، ثم نأخذ المتوسط.

A تدريب→B تحقق+B تدريب→A تحقق

بعد اختيار الإعدادات نعيد التدريب على بيانات التطوير كلها، ثم نفتح مجموعة اختبار مستقلة مرة واحدة.

3) الموجب الكاذب (False Positive, FP) والسالب الكاذب (False Negative, FN)

FP: إنذار كاذب

تنبأ موجباً والحقيقة سالبة. تقليله أهم عندما تكون كلفة الإنذار عالية، مثل رفض دفعة سليمة. نراقب precision وspecificity.

FN: حالة فائتة

تنبأ سالباً والحقيقة موجبة. تقليله أهم عندما يكون الفقد خطيراً، مثل عدم كشف مريض. نراقب recall.

Precision = TP/(TP+FP)
Recall = TP/(TP+FN)
Specificity = TN/(TN+FP)

خفض عتبة القرار (Decision Threshold) يجعل إعلان «موجب» أسهل؛ فينخفض FN عادةً ويزداد FP. لذلك لا توجد عتبة مثالية لكل التطبيقات: نختارها وفق كلفة الخطأ، لا وفق Accuracy وحدها.

4) انتقاء السمات (Feature Selection)

الانتقاء المشرف (Supervised Feature Selection) يرى الوسم ويقيس الصلة بالخرج؛ الانتقاء غير المشرف (Unsupervised Feature Selection) لا يرى الوسم ويعتمد مثلاً على التباين أو التكرار. للمهمة المحددة يكون المشرف غالباً أنفع، لكنه قد يفرط في الملاءمة (Overfitting) أو يفوّت تفاعلاً مثل XOR إذا قيّم كل سمة وحدها. لذلك يُتعلم الانتقاء داخل الجزء التدريبي من كل طية.

مثال يوضح الفرق: قد تختار الطريقة غير المشرفة سمة عالية التباين لكنها لا تساعد في توقع الوسم، بينما يفضّل الانتقاء المشرف سمة أقل تبايناً تفصل الفئات بوضوح. غير المشرف مفيد عندما لا توجد وسوم أو عندما نريد تمثيلاً عاماً؛ المشرف أنسب عندما يكون هدف التصنيف محدداً والوسوم متاحة.
الدورة Bصفحة 2 · س1 · 25 علامة

ثلاث مجموعات، LOOCV، Correlation، والسمات الزائدة

خلاصة نص السؤال: اشرح دور training / validation / test، ولماذا يناسب Leave-one-out CV البيانات القليلة، ولماذا لا يكفي correlation لترتيب السمات. قيّم عبارة «إضافة السمات لا تضر»، ثم اشرح دور C وγ في SVM.

الحل خطوة بخطوة
Training: يتعلم→Validation: يختار→Test: يقدّر التعميم مرة
  • التدريب (Training): يتعلم أوزان النموذج، وبنية الشجرة، وكل تحويل يعتمد على البيانات.
  • التحقق (Validation): يختار العمق وK وC, γ والعتبة وموعد التوقف؛ لا يحدّث الوسائط النهائية مباشرة.
  • الاختبار (Test): يقدّر الأداء على بيانات غير مرئية بعد تجميد جميع القرارات. استخدامه للاختيار يجعل التقدير متفائلاً.

كل معالجة تتعلم أرقاماً - مثل القياس (Scaling) وانتقاء السمات (Feature Selection) - يجب أن تُلائم داخل تدريب الطية. إذا أثرت نتيجة الاختبار في اختيار ما، لم يعد اختباراً.

LOOCV

E^LOO= 1N∑i=1L(yi,f^−i(xi))

كل نموذج يتدرب على N−1 مثالاً، لذلك يستفيد من معظم البيانات القليلة. نترك كل مثال خارج التدريب مرة واحدة بالضبط، نسجل خسارته، ثم نأخذ متوسط خسائر الحالات N. المقابل: N تدريبات، وكل تحقق نتيجة 0 أو 1، والطيات مترابطة؛ لذلك هو مكلف وقد يكون تقديره عالي التباين رغم استخدامه بيانات كثيرة في كل تدريب.

لماذا الارتباط (Correlation) وحده لا يكفي؟

هو مقياس هامشي وغالباً خطي؛ قد تكون كل سمة ضعيفة منفردة لكن الزوج حاسماً، وقد تكون عدة سمات مترابطة نسخاً مكررة من المعلومة نفسها. لذلك يصلح كمرشح سريع، لا كحكم نهائي عند وجود تفاعلات.

مثال التفاعل: قد يكون ارتباط f₃ وf₄ بالخرج ضعيفاً كل على حدة، بينما يكون المجموع f₃+f₄ أو العلاقة XOR(f₃,f₄) حاسماً. الترتيب أحادي المتغير (Univariate Ranking) يفوّت هذه المعلومة المشتركة.
العبارة «السمات الإضافية لا تضر» خاطئة. الضجيج والارتباطات العرضية يرفعان التباين (Variance) والحساب، وقد يسوء أداء الاختبار. كما قد تعني السمات الإضافية أوزاناً أكثر في الشبكة أو عقداً أكثر في الشجرة، فتتسع مساحة البحث. نستخدم التحقق والانتقاء أو التنظيم (Regularization).

C وGamma في SVM

min ½||w||² + C Σξᵢ
K_RBF(x,z) = exp(−γ ||x−z||²)
C ↑

عقوبة متغيرات السماح (Slack Variables) أعلى، فيميل النموذج إلى أخطاء تدريب أقل وقد يفرط في الملاءمة (Overfitting). عرض الهامش لا يتناقص بالضرورة بصورة رتيبة؛ وعند بيانات قابلة للفصل يقترب C→∞ من حل Hard Margin.

γ ↑

تأثير كل عينة محلي وحد متعرج. γ ↓ تأثير أوسع وحد أنعم. نختار الاثنين بالتحقق بعد قياس السمات.

γ معامل في نوى مثل RBF، وليس في Linear SVM. نقيّس السمات أولاً، ثم نبحث عن زوج (C,γ) بالتحقق؛ لأن قيمة كبيرة لكليهما قد تنتج حداً شديد المحلية يطارد الضجيج.

الدورة Cصفحة 4 · س1 · 15 علامة

ثلاثة ادعاءات: خطأ التدريب، 98% Accuracy، واختيار المعاملات

خلاصة نص السؤال: احكم مع التعليل على: «خطأ التدريب منخفض إذاً النموذج جيد»، و«حققنا 98% accuracy لكشف الاحتيال على 50 موجباً و5000 سالباً»، وإجراء اختيار المعاملات بـCV داخل التدريب ثم التقييم مرة على الاختبار.

الحل والأرقام التي تكشف الخدعة
  1. الادعاء الأول غير كافٍ: انخفاض خطأ التدريب (Training Error) لا يثبت التعميم (Generalization). نحتاج خطأ تحقق (Validation Error) منخفضاً أيضاً، ثم اختباراً محفوظاً.
  2. الادعاء الثاني مضلل: مصنف خط الأساس (Baseline Classifier) الذي يقول «سلبي» دائماً يحقق نتيجة أفضل من 98%.
baseline accuracy = 5000 / (5000 + 50) = 99.01%

بل يمكن تحقيق 98% مع TP=0, FN=50, FP=51, TN=4949: لم نكتشف حالة احتيال واحدة. نطلب مصفوفة الالتباس (Confusion Matrix) وPrecision / Recall / F1، ونقرأ منحنى الدقة والاستدعاء (Precision–Recall Curve, PR) عندما تكون الإيجابيات نادرة.

الادعاء الثالث صحيح بشرط العزل: نقسم أولاً، نختار الإعدادات بـCV داخل training فقط، نثبت القرار، نعيد التدريب على training كله، ثم نقيم مرة واحدة على test.

شرط يمنع تسرب البيانات (Data Leakage): أي تحويل يتعلم من البيانات، مثل القياس أو تعويض القيم المفقودة أو انتقاء السمات، يجب أن يُلائم من جديد داخل جزء التدريب من كل طية، لا على كامل بيانات التدريب قبل CV. وإلا تصل معلومات طية التحقق إلى النموذج بصورة غير مباشرة.

الدورة C + Dصفحتا 4 و6

قراءة منحنيات الخطأ وتعريف Bias / Variance / Irreducible error

خلاصة نص السؤال: عيّن منحنيي training وvalidation مع تغير تعقيد النموذج، وحدد مناطق التحيز المرتفع والمنخفض. ما أثر زيادة K في KNN ومضاعفة بيانات Logistic Regression؟ ثم عرّف bias, variance, precision, out-of-sample error, irreducible error.

الحل مع الرسم الذهني
Training and validation error versus model complexity Training error falls continuously. Validation error falls, reaches a minimum, then rises. The left side is underfitting and the right side overfitting. high bias best validation low bias / high variance training validation

المنحنى النازل دائماً هو خطأ التدريب (Training Error)؛ المنحنى على شكل U هو خطأ التحقق (Validation Error). اليسار: نقص ملاءمة (Underfitting) وانحياز (Bias) مرتفع. قرب القاع: أفضل توازن. اليمين: التحيز منخفض لأن النموذج صار مرناً وخطأ التدريب منخفض، لكن التباين مرتفع وخطأ التحقق يصعد؛ أي إفراط في الملاءمة (Overfitting).

زيادة K في KNN

Bias ↑, Variance ↓. الجوار الأكبر ينعّم القرار لكنه قد يمحو بنية حقيقية.

مضاعفة بيانات Logistic Regression

Bias ≈ ثابت, Variance ↓. بنية النموذج لم تتغير، لكن تقدير المعاملات يصبح أكثر استقراراً.

Squared-error regression: Expected test error = irreducible noise + Bias² + Variance
المقدارما الذي يقيسه؟الأفضل
Biasالخطأ المنهجي لمتوسط النموذج عن الدالة الحقيقيةمنخفض
Varianceحساسية النموذج لعينة التدريب المستخدمةمنخفض مع مراعاة التوازن
PrecisionTP / (TP + FP)مرتفع، مع قراءة recall
Out-of-sample errorالخسارة على أمثلة جديدة من التوزيع المستهدفمنخفض
Irreducible errorضجيج أو تداخل لا يزيله حتى أفضل نموذجمنخفض للمهمة، ولا يخفضه التدريب
المحور 2

أشجار القرار وKNN وSVM

الحل الصحيح هنا مرئي: احسب المعلومة، ارسم شكل الحد، ثم اشرح ما الذي يتغير عند إضافة مثال أو تعديل معامل.

افتح دروس الخوارزميات
الدورة Aصفحة 1 · س2 · 30 علامة

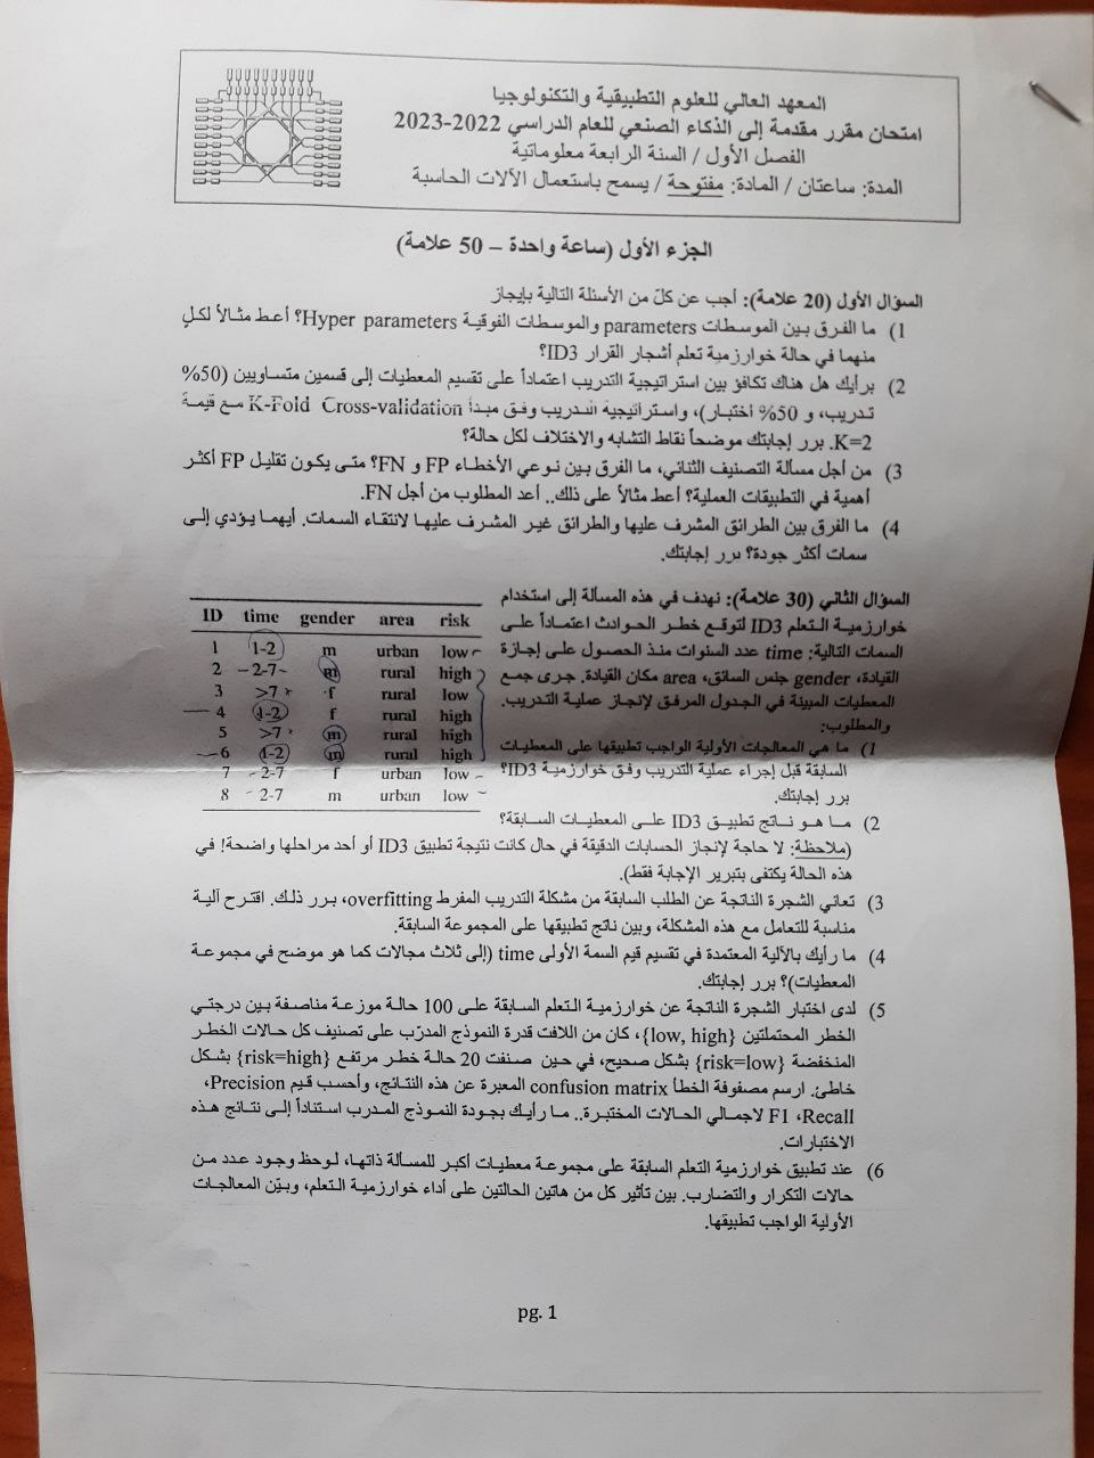
مسألة ID3 كاملة: خطر الحوادث، التقليم، والقياس

خلاصة نص السؤال: طبّق ID3 على 8 سائقين بسمات time, gender, area لتوقع risk. اذكر المعالجة، ابنِ الشجرة، عالج overfitting، قيّم تقسيم time، احسب مصفوفة الخطأ والمقاييس، واشرح أثر التكرار والتضارب.

الحل الكامل من البيانات إلى القرار
IDtimegenderarearisk
11-2murbanlow
22-7mruralhigh
3>7frurallow
41-2fruralhigh
5>7mruralhigh
61-2mruralhigh
72-7furbanlow
82-7murbanlow

1) المعالجة المسبقة (Preprocessing)

  1. احذف ID؛ هو معرّف وقد يجعل الشجرة تحفظ كل صف.
  2. افصل risk كهدف، واترك السمات الثلاث فئوية؛ لا تحتاج إلى التقييس (Standardization).
  3. تحقق من القيم المفقودة والتكرار والتضارب، وطبّق تقسيم time نفسه على أي مثال جديد.

2) اختيار الجذر (Root Selection) بكسب المعلومات (Information Gain)

H(S)=−Σ pᶜ log₂pᶜ = 1
IG(S,A)=H(S)−Σᵥ |Sᵥ|/|S| · H(Sᵥ)
السمةWeighted entropyInformation gain
time0.93870.0613
gender0.95120.0488
area0.45120.5488

إذن الجذر area. الفرع urban نقي: low. داخل rural تتعادل time وgender بقيمة IG=0.3219، لذا أي منهما مقبول حسب قاعدة كسر التعادل.

area? ├── urban → low └── rural → time? ├── 1-2 → high ├── 2-7 → high └── >7 → gender? ├── f → low └── m → high

3) التقليم (Pruning)

الشجرة الكاملة تحقق 100% على ثمانية أمثلة وتنشئ قراراً أخيراً من صف واحد؛ هذا تباين (Variance) مرتفع. إذا اختير max_depth=1 بالتحقق يصبح:

area? ├── urban → low (3 low, 0 high) └── rural → high (1 low, 4 high)

الدقة التدريبية 7/8، لكن القاعدة أبسط وأقل هشاشة.

4) تقسيم السمة المستمرة (Continuous-Feature Split)

الفئتان 1-2 و2-7 تتداخلان عند 2. اجعلهما متنافيتين مثل ≤2, 2<time≤7, >7، أو اختبر منتصف القيم واختر العتبة ذات أعلى كسب معلومات (Information Gain) داخل التدريب.

التقسيم اليدوي قد يهدر ترتيباً أو معلومة مهمة. في الحل المنهجي نرتب قيم time، نختبر العتبات الواقعة بين القيم المتجاورة، نحسب الكسب لكل عتبة، ثم نتحقق من الشجرة الناتجة؛ ولا نحدد العتبة من مجموعة الاختبار.

5) مصفوفة الالتباس (Confusion Matrix)

اعتبر high هو الصنف الموجب. هناك 50 high و50 low؛ كل low صحيح، و20 high أخطأ النموذج فيها.

Actual ↓ / Predicted →highlow
highTP=30FN=20
lowFP=0TN=50
Precision = 30/(30+0) = 1.00
Recall = 30/(30+20) = 0.60
F1 = 0.75, Accuracy = 0.80
كل إنذار high صحيح، لكن النموذج يفوّت 40% من السائقين مرتفعي الخطر. في مسألة سلامة، recall=60% نقطة ضعف خطيرة رغم Accuracy=80%.

6) التكرار (Duplicates) والتضارب (Conflicting Labels)

التكرار المتطابق يعيد وزن الحالة في حساب الكسب (Gain)؛ نحذف النسخ العرضية فقط. التضارب يعني سمات متطابقة مع وسمين مختلفين؛ لا تستطيع شجرة حتمية فصلهما. نراجع الوسم، أو نضيف سمة مميزة، أو نقبل ورقة غير نقية/قاعدة الأغلبية (Majority Rule).

الدورة Bصفحة 2 · س2 · 15 علامة

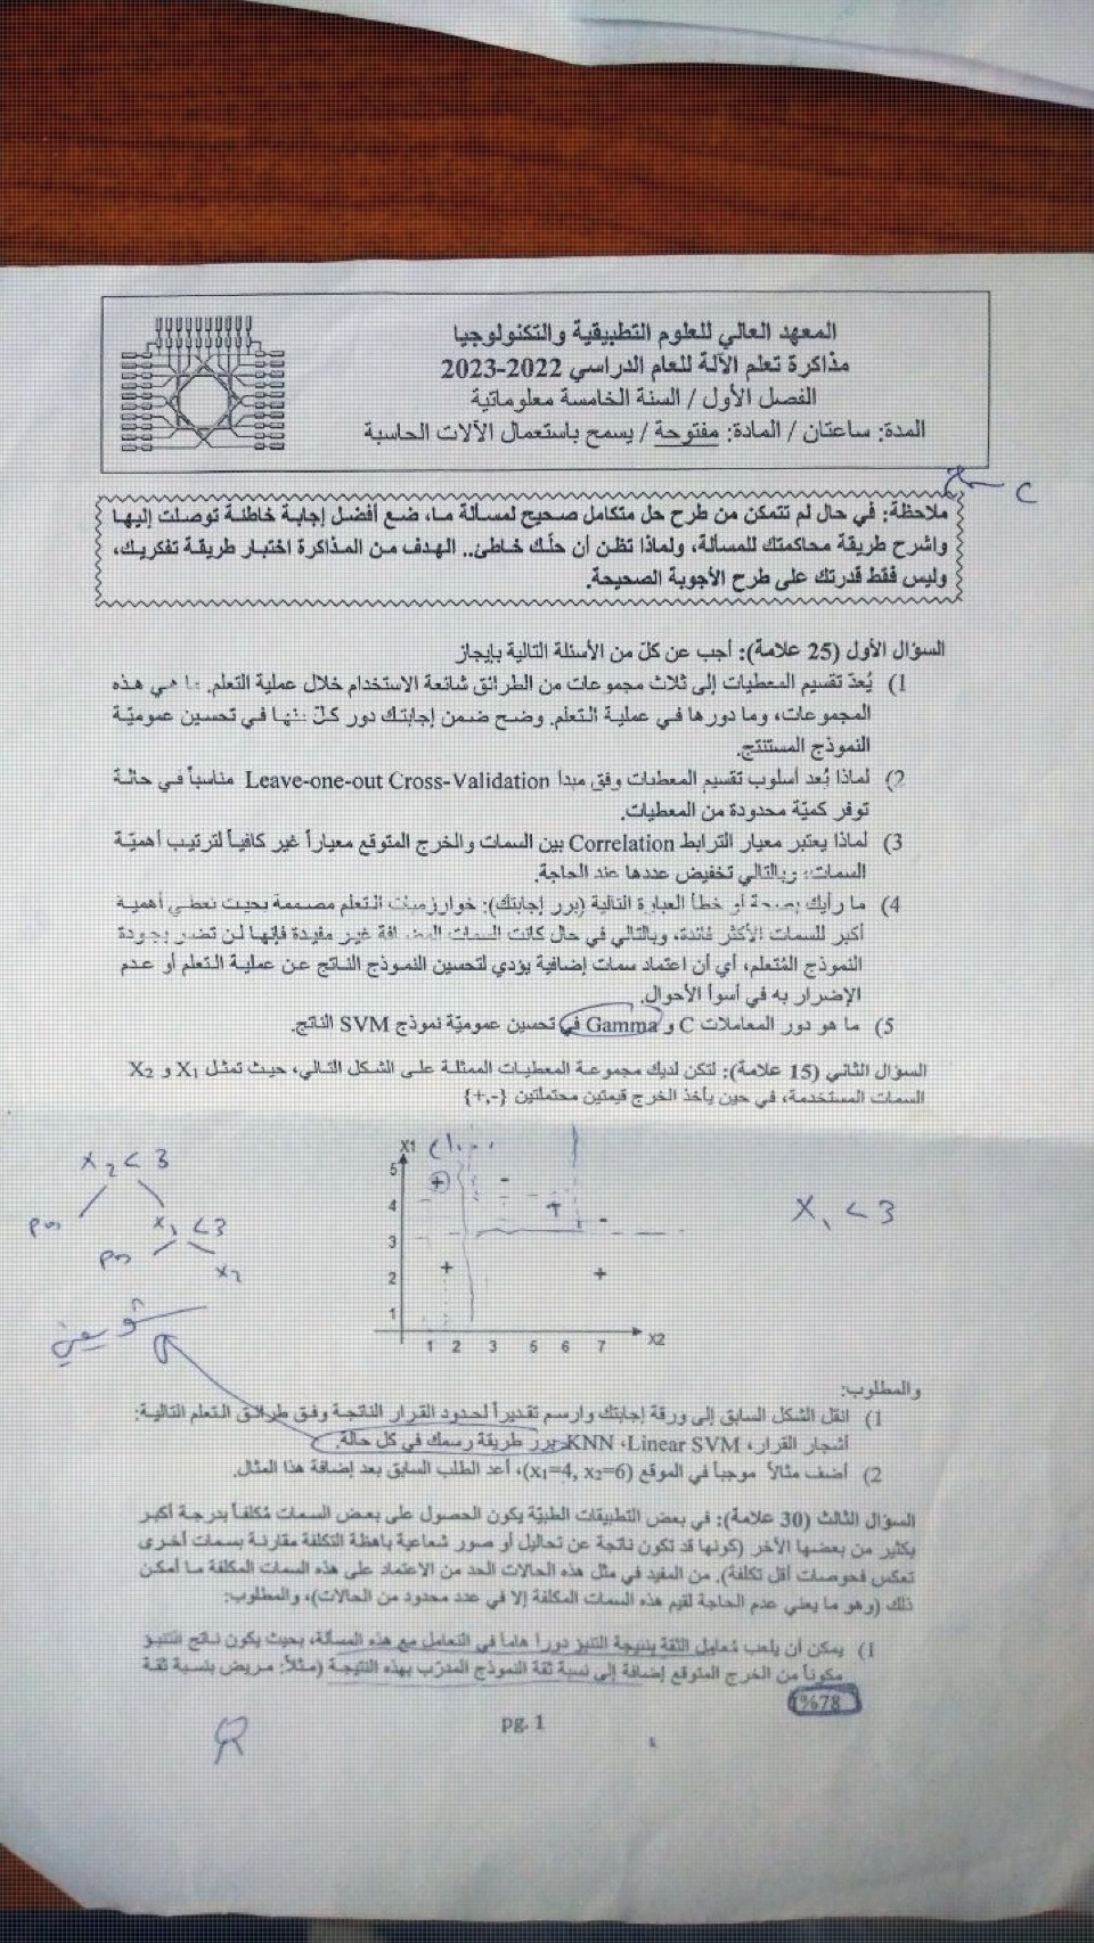
ارسم حدود القرار (Decision Boundaries) لـTree وLinear SVM وKNN، ثم أضف نقطة

خلاصة نص السؤال: على الشكل ذي السمتين X₁, X₂ والصنفين {+,−}، ارسم تقديراً لحدود القرار الناتجة عن شجرة قرار وLinear SVM وKNN. أضف مثالاً موجباً عند (x₁=4,x₂=6) ثم أعد الرسم.

كيف ترسم كل حد ولماذا يتغير؟
السؤال لا يحدد K ولا المسافة ولا القياس. اكتب افتراضك: 1-NN + Euclidean distance. الرسم تقريبي لأن الصفحة تعطي شكلاً لا إحداثيات رقمية كاملة.
  1. انقل النقاط أولاً، ثم اكتب افتراضاتك: شجرة غير مقلمة ذات تقسيمات محورية، وSoft-margin Linear SVM، و1-NN بالمسافة الإقليدية.
  2. ارسم الحدود قبل إضافة النقطة، ثم ضع النقطة الجديدة (4,6),+ فوق الرسم نفسه.
  3. أعد التدريب ذهنياً: الشجرة قد تضيف مستطيلاً، الخط قد يتحرك أو يقبل Slack، و1-NN ينشئ خلية محلية جديدة.
Decision-tree boundary before and after the new positive point Dashed lines are one boundary before the new point. Solid lines add a small axis-aligned positive region around the new point. +++−−★ Decision Tree
متقطع: حد سابق ممكن. متصل: تقسيمات محورية إضافية تصنع جيباً موجباً حول النقطة الجديدة.
Linear SVM boundary before and after the new point A dashed old line and a solid shifted line illustrate how a soft-margin linear SVM may respond to the added positive point. +++−−★ Linear SVM
الخط القديم متقطع. بعد الإضافة قد يدور/يتحرك الحد المتصل أو يقبل مخالفة؛ مقدار التغير يعتمد على C.
One-nearest-neighbor boundary after the new point Voronoi-like edges change locally and form a new positive cell around the added point. +++−−★ 1-NN
تتكون خلية فورونوي موجبة محلية حول النقطة الجديدة؛ المناطق البعيدة لا تتغير.
حد الرسم: هذه تقديرات تعليمية صحيحة للشكل، وليست ناتجاً عددياً وحيداً؛ الامتحان لم يعطِ K أو C أو إعداد التقليم.
الطريقةقبل إضافة النقطةبعد إضافة (4,6),+
Decision Treeحدود أفقية وعمودية تصنع مستطيلات.النقطة تقع في مستطيل سالب؛ الشجرة غير المقلمة تحتاج تقسيمات إضافية (Splits) لصنع جيب موجب صغير، فتزداد الحساسية.
Linear SVMخط مستقيم مع خطي هامش (Margin) موازيين يمران قرب أقرب النقاط.النقطة تقع في الجهة السالبة القديمة؛ الهامش اللين (Soft Margin) يدوّر/يحرك الخط أو يقبل مخالفة (Slack). قيمة C العالية تحركه أكثر.
1-NNخلايا فورونوي (Voronoi Cells)؛ كل منطقة تتبع أقرب عينة، وحد القرار هو الحواف بين خليتين تحمل عينتاهما وسمين مختلفين.تظهر خلية موجبة محلية حول النقطة الجديدة، ولا يتغير إلا الجوار القريب.

القاعدة البصرية التي تكتبها: Tree = مستطيلات، Linear SVM = خط وهامش، 1-NN = حواف Voronoi التي تفصل خليتين متجاورتين من صنفين مختلفين.

الدورة Dصفحة 6 · س2 · 30 علامة

SVM بنواة تربيعية: C، الضجيج، Support Vectors والهامش

خلاصة نص السؤال: ارسم قرار SVM بنواة كثير حدود من الدرجة الثانية عند C→∞ وعند C=0، اختر الأنسب عند وجود 5% أخطاء، أضف نقطة لا تؤثر وأخرى تؤثر، ثم توقّع تغير الهامش بعد حذف أشعة الدعم (Support Vectors) وإعادة التدريب.

الحل مع تصحيح فخ C=0
K(x,z) = (x·z + c)²
min ½||w||² + C Σξᵢ
yᵢ(wᵀφ(xᵢ)+b) ≥ 1−ξᵢ,   ξᵢ≥0

الحد ½||w||² يدفع نحو هامش أعرض، بينما C Σξᵢ يعاقب النقاط التي تدخل الهامش أو تقع في الجهة الخطأ. لذلك C لا «يرسم المنحنى» وحده؛ بل يحدد ثمن مخالفة القيود مقارنةً باتساع الهامش.

aX₁² + bX₁X₂ + cX₂² + dX₁ + eX₂ + f = 0

هذه هي الصورة العامة للحد التربيعي في فضاء السمات الأصلي بعد استعمال النواة؛ قد يكون قطعاً ناقصاً أو مكافئاً أو شكلاً تربيعياً آخر وفق البيانات.

Quadratic SVM sketch when C tends to infinity A tight quadratic curve encloses the upper-right open-circle cluster. Approximate nearest samples are ringed as support vectors. C → ∞ · tight fit · approximate SV rings
نرسم منحنى تربيعياً شديد الالتصاق بالتدريب، ثم نحيط أقرب النقاط على الجانبين بوصفها أشعة دعم تقريبية.
Degenerate SVM sketch for literal C equals zero The training points remain but no useful boundary is drawn because the optimum has w equal to zero. w = 0 no useful decision boundary literal C = 0
عند C=0 حرفياً لا نعاقب الأخطاء، فيفوز w=0 ولا يوجد مصنف عادي صالح للرسم.

حد القرار (Decision Boundary) في المستوى الأصلي منحنى تربيعي بسبب النواة كثيرة الحدود (Polynomial Kernel). عند C→∞ تصبح مخالفات الهامش مكلفة جداً؛ مع ضجيج أو عدم قابلية للفصل قد يلتف الحد لملاحقة التدريب ويرتفع خطر الإفراط في الملاءمة (Overfitting)، أما البيانات القابلة للفصل فتقترب من حل الهامش الصلب (Hard Margin) ذي الهامش الأعظمي بين الحدود عديمة الخطأ. أشعة الدعم (Support Vectors) هي النقاط الأقرب للحد أو داخله، لا النقاط البعيدة في قلب الصنف.

حرفياً C=0 حالة منحلة (Degenerate Case): لا توجد عقوبة على الأخطاء، فيختار الهدف w=0، ولا يبقى حد قرار مفيد. إذا كان المقصود في صياغة الامتحان «C صغير جداً»، فارسم حداً أنعم وهامشاً أعرض يقبل بعض الأخطاء.

مع 5% ضجيج لا نختار أياً من الطرفين حرفياً؛ نختار C>0 متوسطاً بالتحقق. إذا أُجبرت على الخيارين بالمقصود الشائع، اختر C الصغير لأنه لا يطارد الضجيج.

نقطة لا تؤثر

مثال صحيح عميق داخل منطقته وبعيد عن الهامش؛ αᵢ=0.

نقطة تؤثر

مثال متناقض داخل الهامش أو قلب الصنف الآخر؛ يصبح شعاع دعم (Support Vector) أو مخالفاً للهامش (Margin Violator).

بعد حذف أشعة الدعم (Support Vectors): في حالة الهامش الصلب (Hard Margin) القابلة للفصل، مجموعة القيود تصبح أوسع؛ الهامش لا يمكن أن ينقص، وغالباً يزيد عندما تصبح النقاط التالية هي أشعة الدعم الجديدة. قد يبقى نفسه فقط إذا كانت الأشعة المحذوفة زائدة.

margin width = 2 / ||w||
الدورة Dصفحتا 6–7 · س3 · 25 علامة

KNN: لماذا K=1 يفوز تدريبياً ولا نختاره مباشرة؟

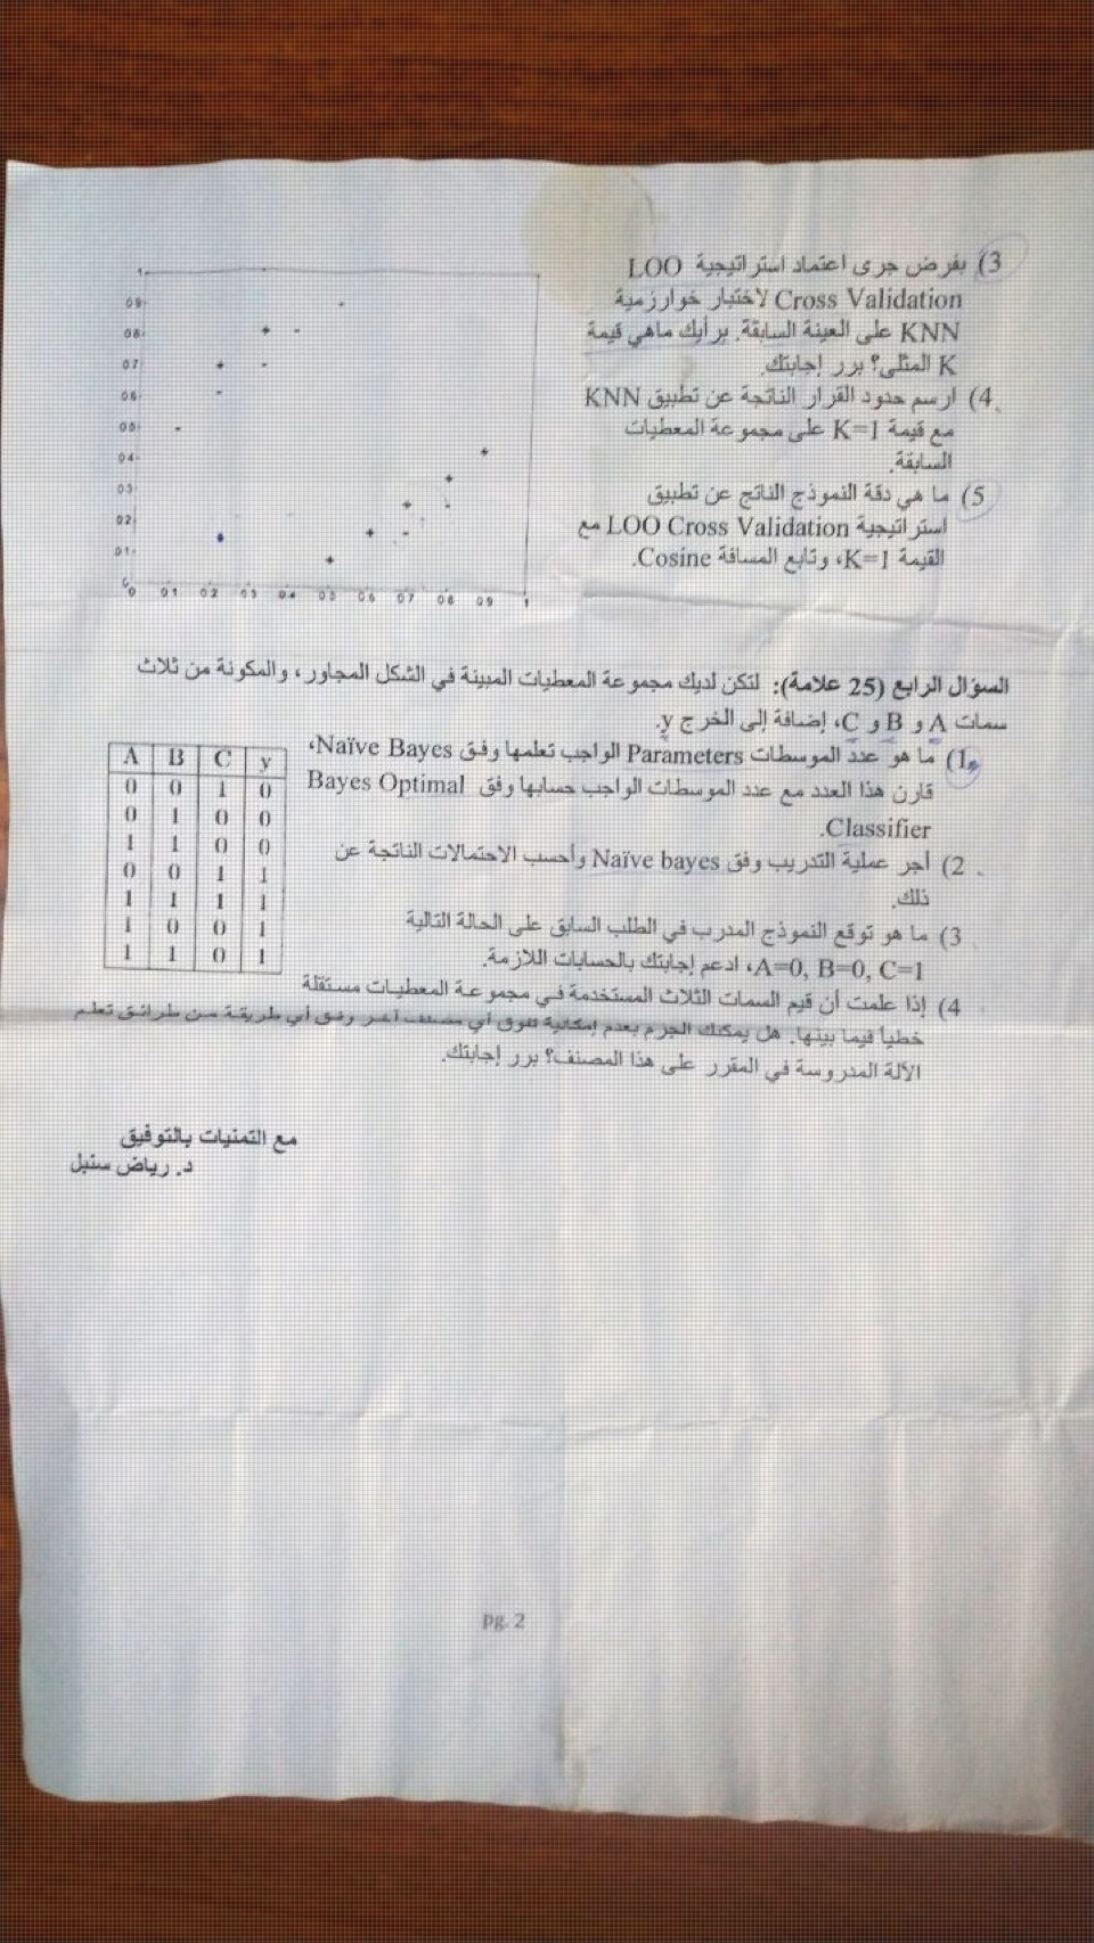
خلاصة نص السؤال: على مجموعة النقاط المرسومة وبالمسافة الإقليدية: ما K التي تعطي أقل خطأ تدريب؟ لماذا تضر K الكبيرة أو الصغيرة جداً؟ اختر K بـLOO CV، وارسم حد K=1، ثم احسب دقة LOO عند K=1 ومسافة Cosine.

الحل الذي لا يخلط التدريب بالتعميم

K=1 يعطي عادة أقل خطأ تدريب - صفراً - لأن كل نقطة هي أقرب جار لنفسها بمسافة صفر. هذا يفترض السماح للنقطة بأن تكون جارة لنفسها وعدم وجود مدخلات متطابقة بوسوم متعارضة. إنه أثر بنيوي، لا دليل جودة؛ في LOO نحذف النقطة، لذلك لا تستطيع «إنقاذ نفسها».

K صغيرة جداً

حد متعرج، تباين (Variance) مرتفع، وحساسية للضجيج. الحد الأدنى العملي للتصنيف الثنائي غالباً K فردية لتجنب التعادل.

K كبيرة جداً

تضم نقاطاً بعيدة ومن الصنف الآخر؛ الحد يصبح ناعماً أكثر من اللازم. عند K=N يتنبأ النموذج بصنف الأغلبية (Majority Class) في كل مكان.

نختار K ذات أصغر خطأ تحقق (Validation Error)، لا أصغر خطأ تدريب (Training Error):

K* = argminₖ (1/N) Σᵢ 𝟙[ŷ₋ᵢ,ₖ(xᵢ) ≠ yᵢ]
  1. اختر قيماً مرشحة، وغالباً قيماً فردية مثل 1, 3, 5, … لتقليل التعادل في التصنيف الثنائي.
  2. لكل نقطة i: احذفها، ابحث عن أقرب K نقاط من البقية، ثم صوّت.
  3. احسب عدد أخطاء الحالات N، وكرر العملية لكل K.
  4. اختر أقل خطأ LOO؛ وإذا تعادلت قيمتان، فالقيمة الأبسط/الأكبر قليلاً تعطي حداً أنعم، مع ذكر قاعدة كسر التعادل.

حد 1-NN هو حدود خلايا فورونوي (Voronoi Cells): منصفات عمودية بين كل نقطة وأقرب نقطة منافسة.

الحساب العددي الأخير لا يُثبت من الصورة وحدها. الرسم لا يعطي جدول إحداثيات دقيقاً ولا يوضح كل الرموز بما يكفي لإعادة مسافات cosine دون تخمين. لذلك تعرض الصفحة الطريقة الصحيحة ولا تدّعي نسبة مصطنعة: احذف النقطة i، احسب cosine distance إلى بقية النقاط، خذ أقرب وسم، وكرر N مرة.
d_cos(x,z) = 1 − (x·z)/(||x|| ||z||)

مسافة جيب التمام (Cosine Distance) تقارن اتجاه المتجهين من نقطة الأصل، لا قربهما الإقليدي. لذلك قد تصبح نقطتان على الشعاع نفسه جارتين حتى لو اختلف مقدارهما كثيراً. في كل طية نختار j* = argminⱼ d_cos(xᵢ,xⱼ) مع j≠i، ثم نحسب Accuracy = correct/N.

المحور 3

التحسين وCNN وRNN

نربط كل بنية بوظيفتها، ونحسب الشكل وعدد الوسائط قبل أن نقترح تدريباً أو إعادة استخدام.

افتح دروس التعلم العميق
الدورة Cصفحة 4 · س3 · 20 علامة

أربع مقارنات جوهرية في سطرين لكل واحدة

خلاصة نص السؤال: اذكر فرقاً جوهرياً بين: Mini-batch GD / SGD، وMomentum / GD، وCNN / DNN، وBidirectional LSTM / LSTM.

الإجابة الامتحانية المباشرة
الثنائيةالفرق الحاسم
Mini-batch / SGDSGD الحقيقي يستخدم مثالاً واحداً: رخيص وضجيجه عالٍ. الدفعة المصغرة (Mini-batch) تأخذ متوسط B أمثلة: أقل ضجيجاً وتستفيد من العتاد المتوازي.
Momentum / GDالانحدار المتدرج (Gradient Descent, GD) يستخدم التدرج الحالي فقط. الزخم (Momentum) يجمع الاتجاهات المتسقة ويلغي الاهتزاز المتناوب.
CNN / Dense DNNCNN نوع متخصص من DNN؛ والمقارنة المقصودة مع Dense DNN. الأولى تستخدم وصلات محلية ومشاركة أوزان (Weight Sharing) وتحفظ البنية المكانية؛ الثانية كاملة الاتصال ولا تستغل المحلية (Spatial Locality) تلقائياً.
BiLSTM / LSTMBiLSTM ترى الماضي والمستقبل وتحتاج التسلسل كاملاً؛ LSTM الأحادية سببية (Causal) ويمكن تشغيلها لحظياً (Online).
vₜ = βvₜ₋₁ + gₜ
θₜ₊₁ = θₜ − ηvₜ

ملاحظة اصطلاحية: SGD الصرف يستخدم مثالاً واحداً في التحديث، لكن بعض المكتبات تستعمل الاسم نفسه عند التدريب بدفعات مصغرة. في الامتحان اذكر حجم الدفعة صراحةً حتى لا يصبح الجواب ملتبساً.

الدورة Cصفحتا 4–5 · س4 · 30 علامة

حالة CNN كاملة لصور شعاعية 128×192×1

خلاصة نص السؤال: صنّف صوراً شعاعية رمادية 128×192 إلى سليم/مريض باستخدام CNN ثم طبقتين fully connected. اشرح الأدوار، احسب خرج الطبقة الثالثة من جدول البنية، قيّم التصميم، اشرح التدريب، احسب وسائط أول Conv، اقرأ منحنيات الخطأ، ثم اقترح حلاً رخيصاً لتصنيف حدة المرض.

الحل الكامل مع حالتي Padding

لماذا الشبكة الالتفافية (Convolutional Neural Network, CNN)؟

الصورة لها بنية مكانية (Spatial Structure). تتعلم CNN أنماطاً محلية بمرشحات مشتركة (Shared Filters)، ثم تجمعها إلى سمات أعلى (High-level Features)؛ الطبقات الكثيفة (Dense Layers) تدمج السمات وتنتج قراراً ثنائياً.

128×192×1→Conv blocks→Pooling→Flatten→Dense→احتمال المرض

حساب شكل الخرج (Output Shape) للطبقة الثالثة

Nout = floor((N + 2P − K)/S) + 1

الجدول لا يذكر الحشو (Padding)، لذلك لا يوجد جواب وحيد:

valid (P=0)

Conv1: (128−3)+1=126
and (192−3)+1=190
Conv2: 126→124, 190→188
Pool: floor((124−2)/2)+1=62
and floor((188−2)/2)+1=94
Output: 62×94×64

same convolutions

128×192×1
→128×192×64
→128×192×64
→64×96×64

التجميع (Pooling) يخفض الارتفاع والعرض ولا يغير عدد القنوات، لذلك تبقى القنوات 64. في حالة same تحفظ طبقتا الالتفاف الحجم، ثم يخفضه 2×2, stride 2 إلى النصف.

التصميم شبيه بـVGG: مرشحان 3×3 ثم تجميع، مع زيادة القنوات 64→128→256. تكديس مرشحين 3×3 يعطي مجال استقبال فعالاً يقارب 5×5 ويضيف لاخطية ثانية؛ التجميع يخفض الدقة المكانية، وزيادة القنوات تسمح بتعلم أنواع أكثر من السمات. الفكرة مبررة، لكن يجب التصريح بالحشو (Padding) ودالة التنشيط (Activation Function).

كيف نختار البنية؟ نثبت تقسيم التحقق، نقارن عدداً محدوداً من الأعماق والقنوات والحشو، ثم نختار أقل خسارة تحقق. لا نبرر عمق الشبكة أو عدد قنواتها بانخفاض خطأ التدريب وحده.

التدريب (Training) وعدد الوسائط (Parameter Count)

ندرب الطرفين من النهاية إلى النهاية (End-to-End): الخسارة تعيد الانتشار الخلفي (Backpropagation) عبر الرأس الكثيف ثم CNN، ويحدّث المحسّن (Optimizer) جميع الأوزان.

Pconv = (Kh·Kw·Cin + 1)·Cout
(3·3·1 + 1)·64 = 640

كل مرشح يملك 3×3×1=9 أوزان وانحيازاً واحداً، أي 10 وسائط. لدينا 64 مرشحاً، لذا 10×64=640. من دون الانحياز تصبح 9×64=576. مشاركة الأوزان تعني أن المرشح نفسه يمر على كل المواضع؛ في الانتشار الخلفي تُجمع مساهمات تلك المواضع قبل تحديثه.

للتصنيف الثنائي نستخدم خرج Sigmoid واحداً وخسارة Binary Cross-Entropy. تمر الدفعة للأمام لإنتاج الاحتمال، نحسب الخسارة، نعيد المشتقات للخلف، ثم يحدّث المحسّن الأوزان. نقيس التحقق بين الحقب ولا نلمس الاختبار النهائي حتى تثبيت التصميم ونقطة التوقف.

منحنيات الخطأ (Learning Curves)

خطأ التدريب (Training Error) يواصل الانخفاض وخطأ التحقق (Validation Error) يرتفع بعد قاعه: هذا إفراط في الملاءمة (Overfitting). بداية المشكلة هي حقبة أقل خسارة تحقق، لا آخر حقبة. نطبق الإيقاف المبكر (Early Stopping): نحفظ أفضل نقطة تحقق (Checkpoint)، نسمح بعدد صبر صغير من الحقب، ثم نعيد أفضل أوزان. بعد تثبيت ذلك نقيم الاختبار مرة واحدة.

نقل التعلم (Transfer Learning) للمهمة الجديدة

  1. أعد استخدام CNN لأنها تعلمت سمات صور شعاعية من النوع نفسه.
  2. احذف الرأس القديم، جمّد CNN (Freeze)، وأضف رأس تصنيف (Classification Head) جديداً لفئات حدة المرض.
  3. درّب الرأس فقط؛ إن لم يكف الأداء، فك آخر كتلة (Block) واضبطها دقيقاً (Fine-tuning) بمعدل تعلم صغير.
الدورة Cصفحة 5 · س5 · 15 علامة

توقع سلسلة زمنية: شبكة بسيطة ثم RNN

خلاصة نص السؤال: صمم حلاً يتنبأ بالقيمة المستقبلية من سجل القيم السابقة: مرة بشبكة عصبونية بسيطة ومرة بـRNN. وضح الدخل والخرج والبنية ودلالة المكونات وتجهيز التدريب والاختبار.

من Window واحدة إلى النموذجين

اختر طول ذاكرة L، وحوّل السلسلة إلى نوافذ (Windowing):

X(t) = [z(t−L+1), …, z(t)]
y(t) = z(t+1)
[z₁,z₂,z₃]→z₄;[z₂,z₃,z₄]→z₅

في المثال L=3: كل دخل يحتوي ثلاث قيم متتالية والهدف هو القيمة التالية. نضع النوافذ ذات الأهداف قبل نقطة القطع في التدريب، وما بعدها في التحقق/الاختبار؛ ولا نسمح لنافذة تدريب أن تستخدم قيمة من المستقبل.

استخدم تقسيماً زمنياً (Temporal Split)، لا تقسيماً عشوائياً. درّب المقياس على الماضي التدريبي فقط ثم طبقه على Validation / Test؛ وإلا حدث تسرب بيانات (Data Leakage) من المستقبل.
MLP

L inputs → Dense(h, ReLU) → Dense(1, linear)

تتعلم الطبقة المخفية (Hidden Layer) تركيباً لاخطياً لنافذة ثابتة.

a = ReLU(W₁X+b₁)
ẑ(t+1) = W₂a+b₂

الدخل L قيم، والطبقة المخفية تنتج h سمات، والخرج الخطي يعطي قيمة مستمرة واحدة.

RNN

sequence L×1 → RNN(h) → Dense(1)

الحالة المخفية (Hidden State) ذاكرة جارية، والأوزان نفسها يعاد استخدامها في كل خطوة (Weight Sharing).

تلخص hᵢ ما شوهد حتى الزمن i، ويستخدم الرأس hL بعد آخر قيمة في النافذة لإنتاج التنبؤ.

hᵢ = tanh(Wx zᵢ + Wh hᵢ₋₁ + b)
ẑ(t+1) = Wy hL + by

الفرق الحاسم: MLP تستقبل نافذة بطول ثابت ولها أوزان مختلفة لمواضع الدخل، بينما RNN تعيد التحويل نفسه زمنياً وتحمل حالة مخفية. أثناء التدريب نفردها عبر الخطوات ونطبق الانتشار الخلفي عبر الزمن (Backpropagation Through Time, BPTT).

الخسارة الطبيعية للقيمة المستمرة هي متوسط مربع الخطأ (Mean Squared Error, MSE). للتنبؤ متعدد الخطوات (Multi-step Forecasting) يمكن إعادة كل تنبؤ إلى النافذة التالية، مع الانتباه إلى تراكم الخطأ (Error Accumulation).

مستبعد بوضوح

أسئلة موجودة في الصور لكن خارج حدود الدليل الحالي

الرجوع إلى الأصل

صور الصفحات السبع

افتح أي صورة ثم اضغط عليها لفتح الصفحة نفسها داخل ملف PDF. النص المكتوب في البطاقات منسوخ بصورة محافظة؛ تبقى الصورة هي المرجع عند اختلاف كلمة غير واضحة.

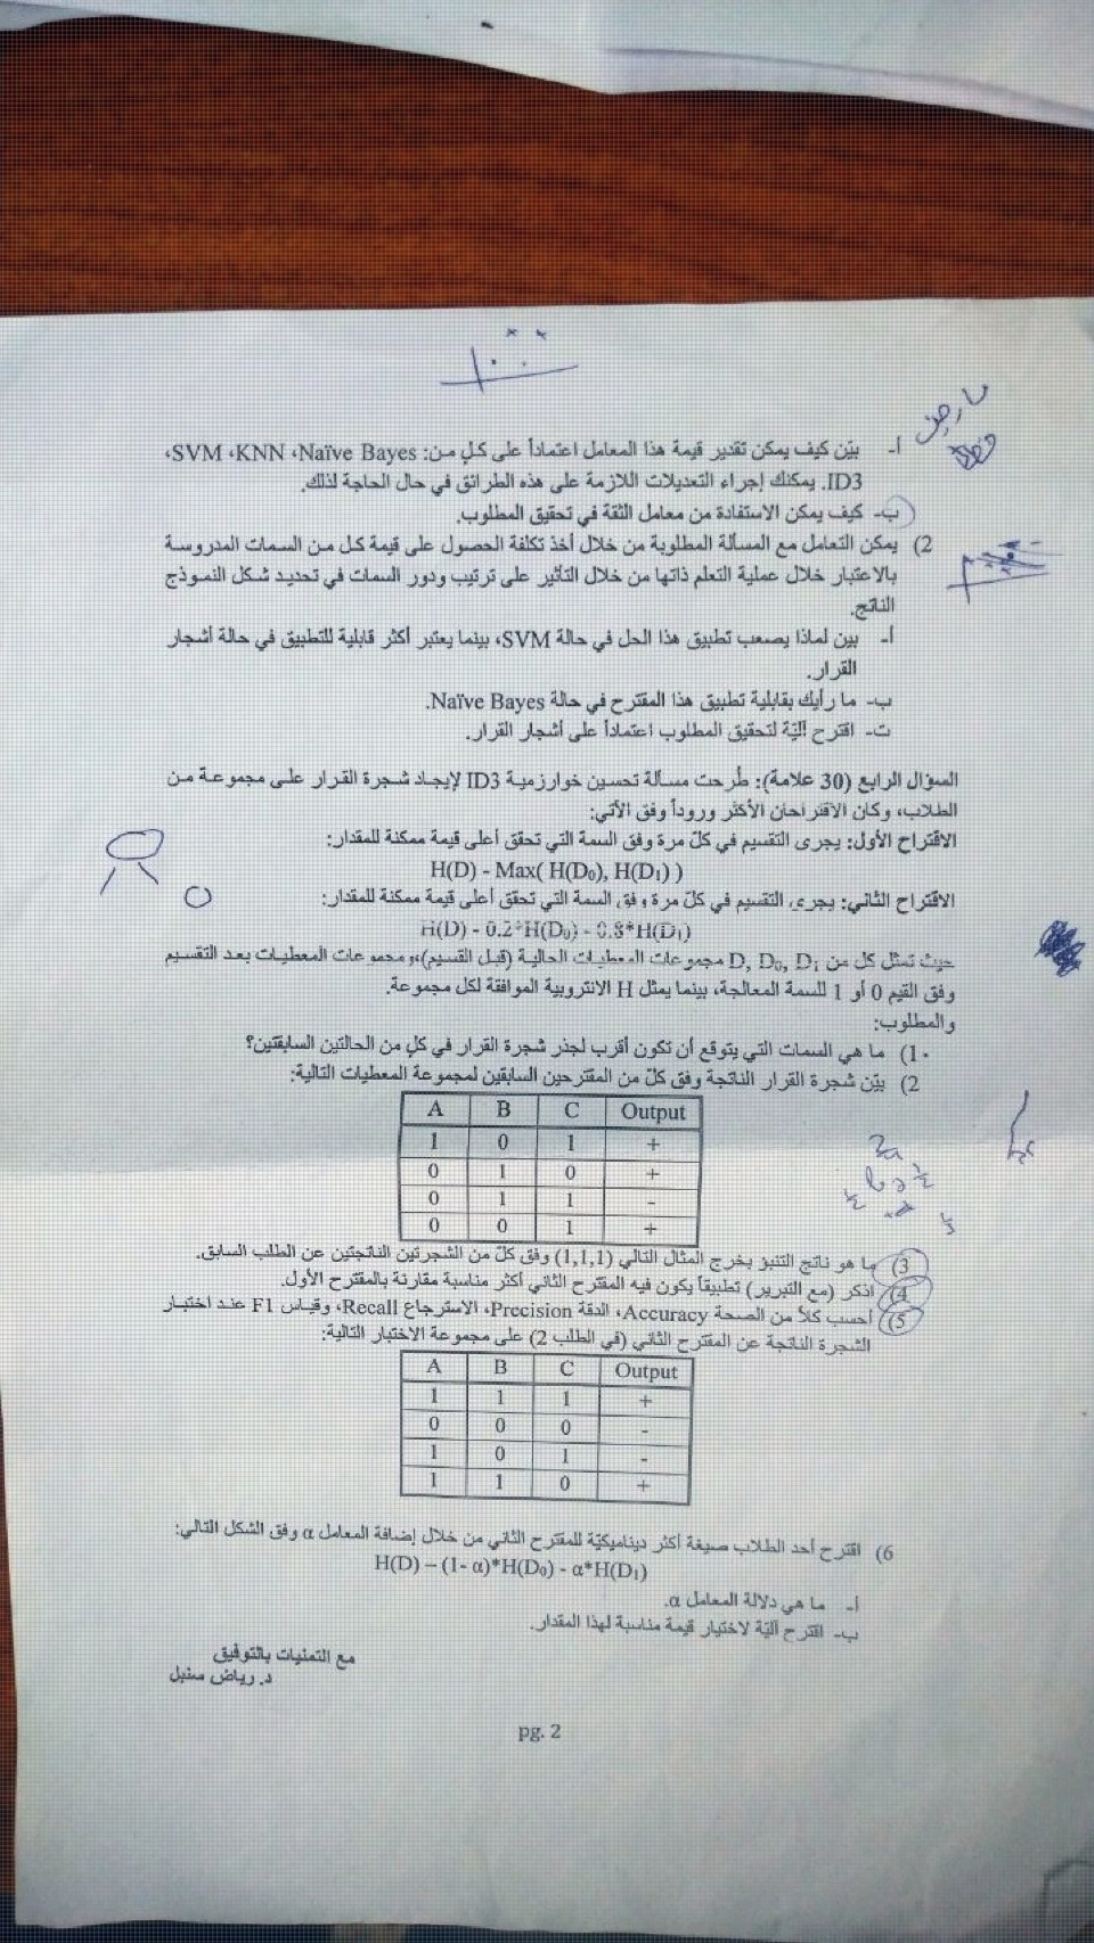
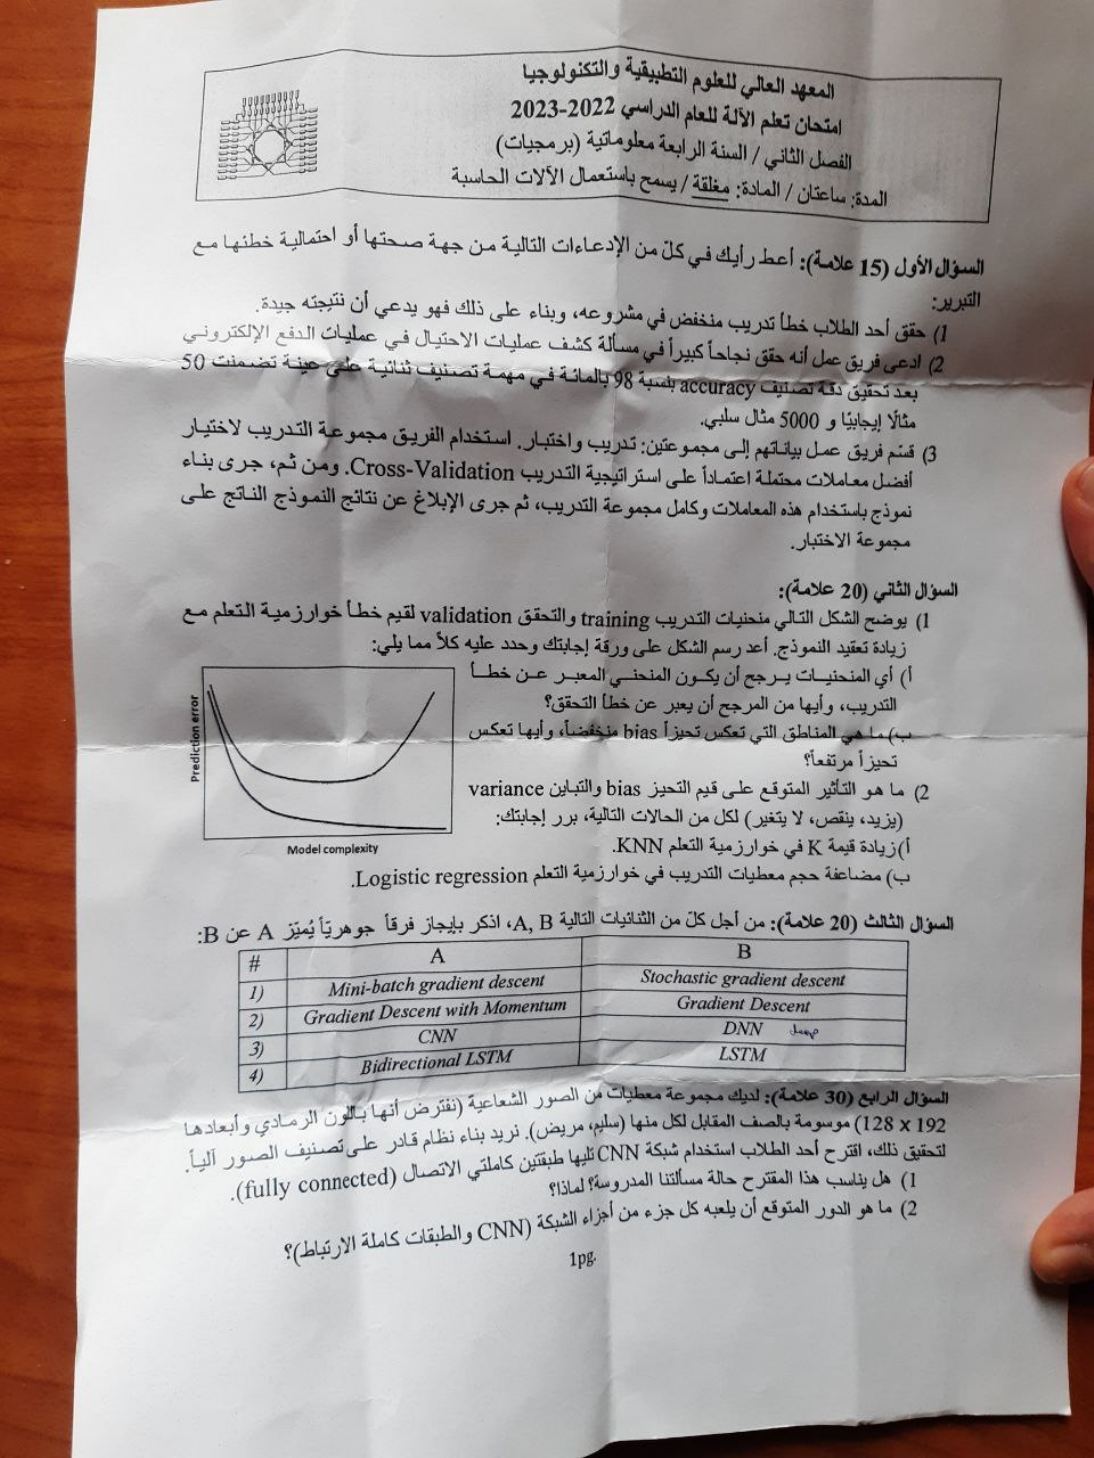
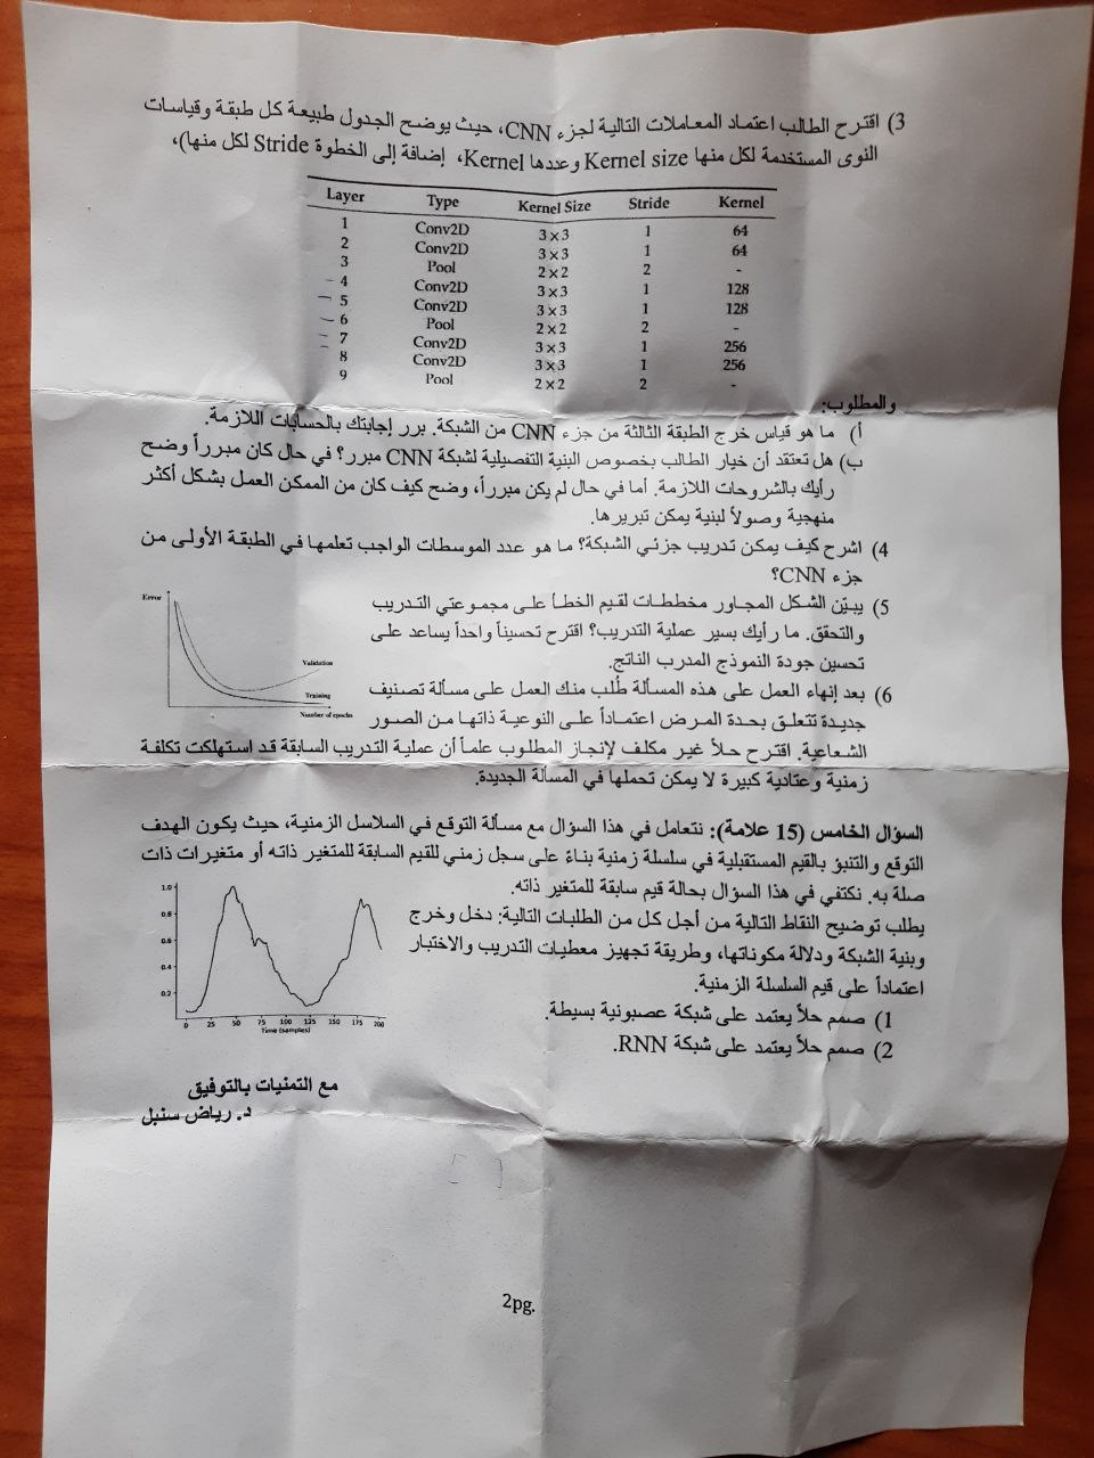
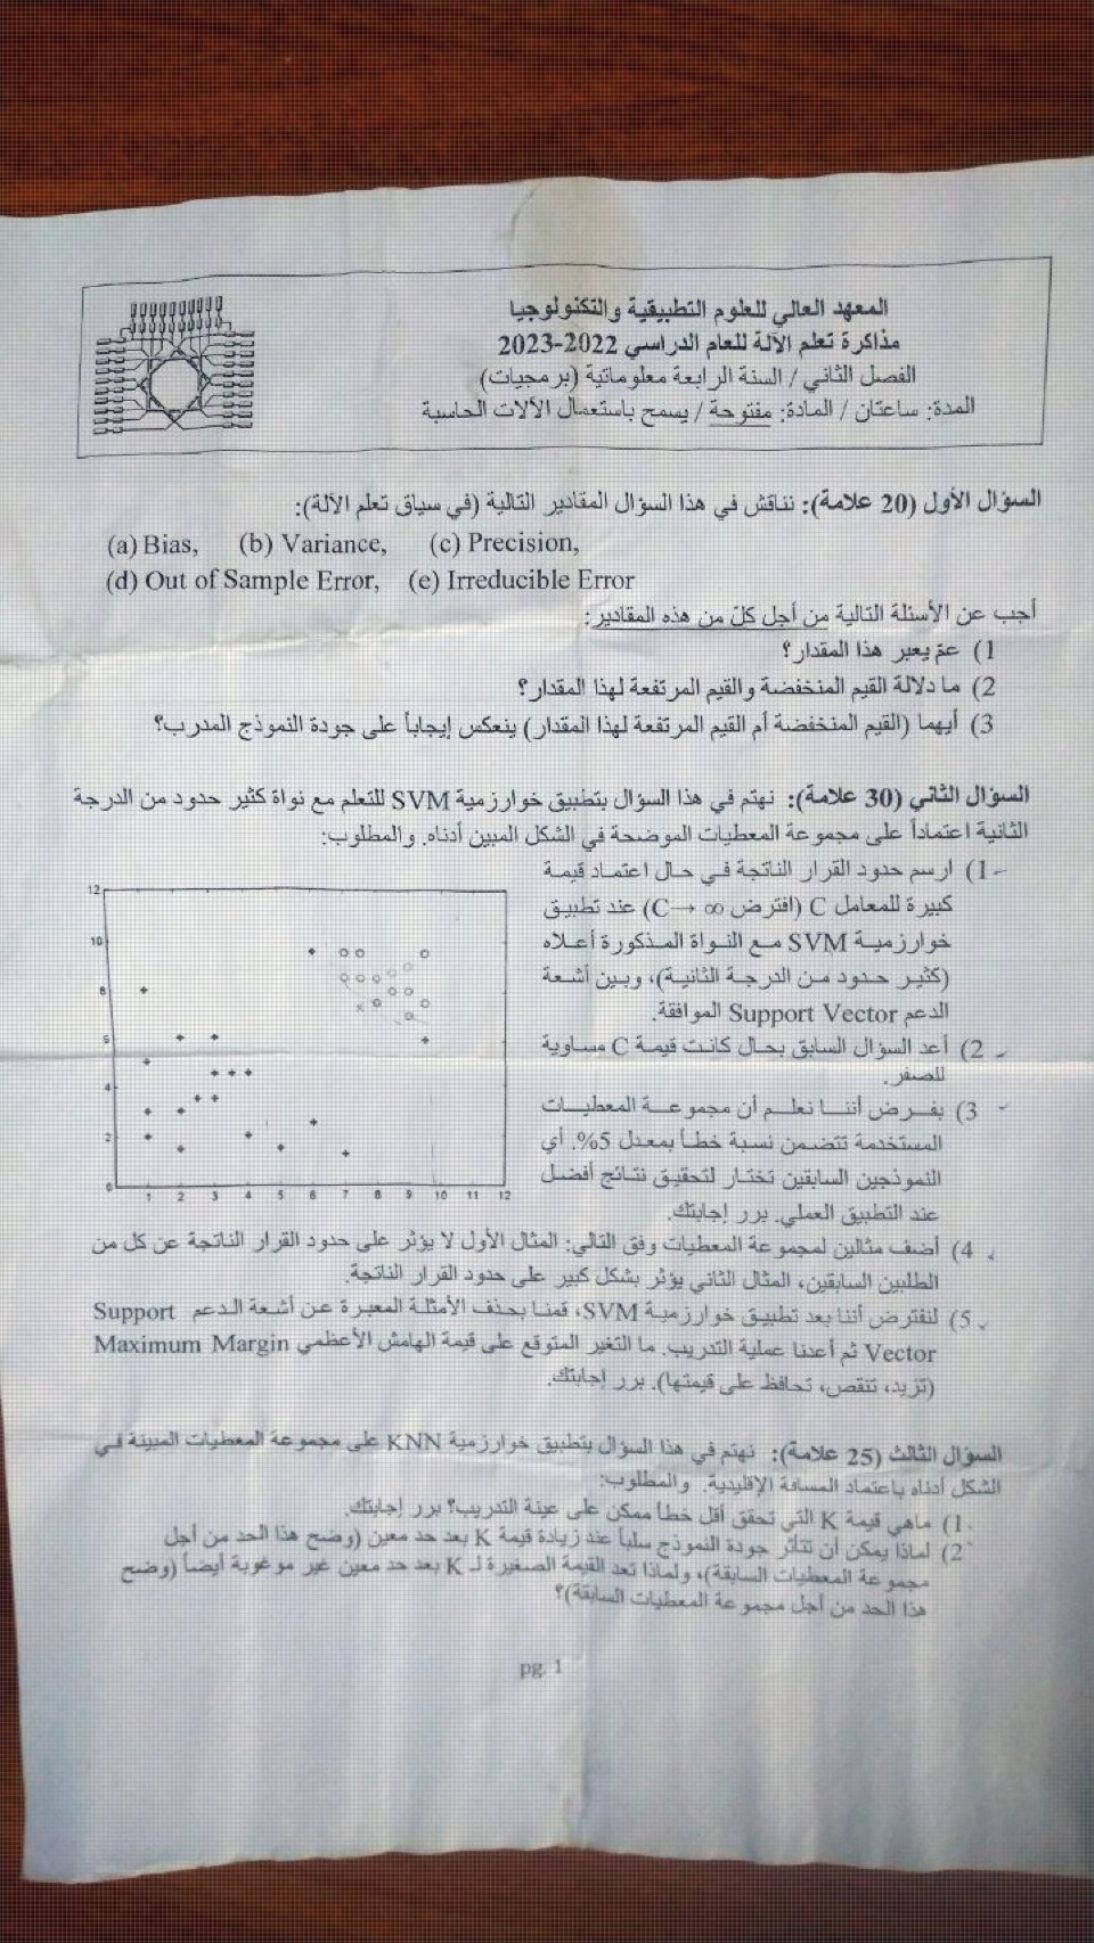
الصفحة 1 · ID3 والتقييمصورة الصفحة الأولى من دورات سنبل، وفيها سؤال المفاهيم ومسألة ID3
الصفحة 2 · التقسيم والحدودصورة الصفحة الثانية من دورات سنبل، وفيها التقسيم وLOOCV ورسم الحدود
الصفحة 3 · مواد مستبعدةصورة الصفحة الثالثة من دورات سنبل، وفيها أسئلة تكلفة السمات وmodified ID3 المستبعدة
الصفحة 4 · التعميم وبداية CNNصورة الصفحة الرابعة من دورات سنبل، وفيها التقييم والتحيز والتباين وبداية CNN
الصفحة 5 · CNN وRNNصورة الصفحة الخامسة من دورات سنبل، وفيها بنية CNN ومسألة السلسلة الزمنية
الصفحة 6 · SVM وKNNصورة الصفحة السادسة من دورات سنبل، وفيها مفاهيم التعميم ومسألة SVM وبداية KNN
الصفحة 7 · بقية KNNصورة الصفحة السابعة من دورات سنبل، وفيها بقية KNN وسؤال Naive Bayes المستبعد